Google 要不要 × AI 要不要|同一篇文章的兩個獨立軸線
搜尋收錄等於被看見、被看見就有人點進來,這條鏈成立了二十年,現在斷成兩截。搜尋要不要與 AI 要不要交叉出四個象限,其中最容易誤判的那一格用點擊率看會顯示衰退,實際上它是站上最被使用的資產。
搜尋收錄等於被看見、被看見就有人點進來,這條鏈成立了二十年,現在斷成兩截。搜尋要不要與 AI 要不要交叉出四個象限,其中最容易誤判的那一格用點擊率看會顯示衰退,實際上它是站上最被使用的資產。
報表真正在做的事不是告訴你發生了什麼,是告訴你先看哪一個;而先看哪一個的另一面,就是決定其他的今天不看。機器排得出優先度,排不出「我知道這篇有問題」——這一步沒辦法省略,它同時是整個系統的瓶頸與價值所在。
這套系統真正的產出不是資料,是需要我親自判斷的事一年比一年少;成熟度不是資料量,是人不用再看的比例。今天數得出來的是五項,另有兩項刻意不交、一類結構上交不出去——而天花板的位置,比我原本以為的低。
字面比對會同時看漏和看錯:用字不重疊的兩句話可能問同一件事,只差兩個字的兩句話可能是完全不同的人。語意比對換一種量法,把每段文字放上地圖看距離,於是看得見原本看不見的自相殘殺。
多數人以為資料的敵人是髒,其實是對不齊。從同一篇文章被認成好幾筆、比率被拿去相加,到 Search Console、Bing、GA4、Cloudflare、AdSense 五家的時間刻度全都不一樣——最後一種不是技術問題,是判斷。
接上儀表之後看到什麼:Google Search Console、Bing Webmaster、GA4、Cloudflare 與 AdSense 六路資料各自補一塊別人補不了的缺口,交叉之後浮出四種單一報表看不見的市場地形。
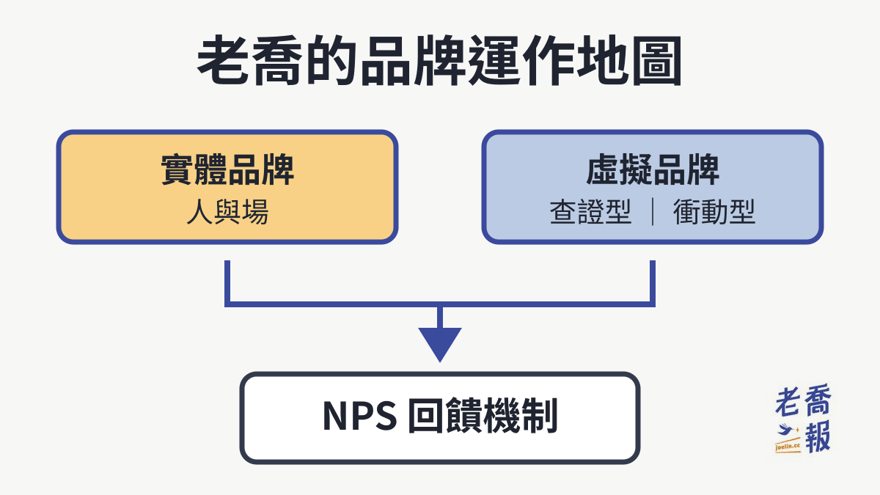
老喬做品牌、內容與事業共用的一張運作地圖:先分實體品牌與虛擬品牌,虛擬再分查證型與衝動型流量,最後用 NPS 回饋機制接成營運循環,並把線下資料反哺線上。每一格都指回站上既有文章。
不露臉可以做自媒體嗎?可以,而且會逼你把信任建在內容資產而非臉上。本文拆解不露臉經營的信任來源、適合的平台選擇(部落格、電子報、Podcast、純文字社群),以及用自媒體矩陣資產層打法搭建內容系統的具體步驟。